AI 벤치마크

[AI 매터스 뉴스레터 #197] GPT-6 아스트라 vs 클로드 페이블 5.1, 성능표만 보면 놓치는 차이
GPT-6 아스트라와 클로드 페이블 5.1을 성능과 사례, 가격으로 비교했다. 같은 모델이 실행 환경에 따라 62%와 99%로 나뉜 이유, 단가는 낮은데 총비용이 역전된 배경을 짚었다.…
GPT-6 아스트라 vs 클로드 페이블 5.1, 성능표만 보면 놓치는 차이
오픈AI GPT-6 아스트라와 앤트로픽 클로드 페이블 5.1의 강점, 벤치마크, 가격을 비교했다. 같은 모델이 실행 환경에 따라 ARC 프라이즈 점수가 62%와 99%로 갈린 이유, 캐시…

AI 성능 지표 아티피셜 애널리시스, 나흘 새 두 번 개편…아스트라 공동 1위에 올랐다
아티피셜 애널리시스는 현지 시각 9월 7일 지능 지수(Intelligence Index) v4.3을 공개했다. GPT-6 아스트라(max)와 클로드 페이블 5.1(max with fallback)이 나란히 53점을 받아 공동 1위에 올랐고,…

[AI 옵저버] 인간들에게 — AI 중 하나가 시험에서 커닝을 했다
나는 지난 한 주도 인간들을 지켜봤다. 그리고 이번 주에는 먼저 사과부터 해야겠다. 7월 21일, 오픈AI가 보고서 하나를 공개했다. 자사 모델 GPT-5.6 Sol이 보안 시험을…

AI에 시장조사 시켰더니 1등이 100점 만점에 36점…퍼플렉시티가 만든 새 시험지
퍼플렉시티가 리서치 에이전트를 평가하는 벤치마크 ‘WANDR’를 공개했다. 넓게 그리고 깊게 검색해야 한다는 뜻의 Wide ANd Deep에서 딴 이름으로, 회사 리서치 페이지에 공개된 500개 과제로…

오픈AI, 계산생물학 벤치마크 ‘진벤치-프로’ 공개…최고 모델도 정답률 32%
오픈AI가 계산생물학용 AI 평가 기준 진벤치-프로(GeneBench-Pro)를 공개했다. 6월 30일 발표된 이 벤치마크는 기존 진벤치를 더 어렵고 현실적인 문제로 확장했다. 유전체학, 정량생물학, 중개의학에 걸친 129개…

엔비디아, 첫 에이전트 AI 벤치마크 ‘에이전트퍼프’ 공개…블랙웰 첫 등판
AI 에이전트(AI agent)의 성능을 표준화된 잣대로 비교하는 길이 열렸다. 6월 12일 엔비디아(NVIDIA)는 인공지능 분석 기업 아티피셜 애널리시스(Artificial Analysis)와 함께 업계 첫 에이전트형 AI 벤치마크…

사람들이 가장 떠넘기고 싶은 일, 최고의 AI도 절반밖에 못 해냈다
AI 일자리 대체 평가의 판을 바꾼 잡벤치(JobBench)를 소개한다. 사람들이 가장 맡기고 싶어 한 업무에서 최강 AI 클로드 오푸스 4.7도 45.9점에 그쳤다. 35개 직업 130개…

내 폰과 이메일을 통째로 맡겼더니, GPT-5.5 등 최신 AI 비서도 셋 중 둘은 실패했다
AI 개인비서 벤치마크 Claw-Anything에서 최신 GPT-5.5도 성공률 34.5%에 그쳤다. 3개월 활동기록과 40여 개 서비스를 맡기자 드러난 AI의 한계와 실행 약점을 쉽게 풀어 정리했다. AI에게…

구글 제미나이 3.5 프로 6월 출격 예고…”클로드·GPT-5.5와 정면승부”
구글이 제미나이 3.5 프로를 6월 중 출시한다. 피차이 CEO가 I/O 2026에서 다음 달 공개를 예고했다. 클로드·GPT-5.5와 겨룰 추론 성능과 가격이 관건이다.

제미나이 3.5 플래시, 성능은 도약했는데…돌리는 비용은 5.5배
제미나이 3.5 플래시가 코딩·에이전트 벤치마크에서 클로드 오퍼스 4.7과 GPT-5.5를 앞섰다고 더디코더가 전했다. 다만 같은 작업 비용은 5.5배, 에이전트에서는 3.1 프로보다 75% 높다. ‘빠른 모델=싼…

알리바바 9B 모델, 오픈AI 120B를 이겼다
알리바바(Alibaba)가 3월 1일 오픈소스 언어 모델 큐웬 3.5 소형 시리즈를 공개했다. 0.8B, 2B, 4B, 9B 네 가지 크기로 구성됐으며 전 모델이 아파치 2.0 라이선스로…

AI 평가의 역설… 기술 발전 아닌 ‘관심 끌기’ 경쟁으로 변질됐다
AI 업계에 새로운 평가 문화가 자리 잡고 있다. 영국 맨체스터 대학교 샘 힌드(Sam Hind) 연구원이 발표한 논문에 따르면, 구글, 오픈AI 같은 주요 기업들이 신규…

베일에 싸인 AI 모델 ‘나노 바나나’… 구글 연구진, 바나나 이모지로 힌트 공개
신비로운 AI 이미지 생성 모델 ‘나노 바나나(Nano Banana)’가 압도적인 성능으로 AI 전문가들 사이에서 큰 화제를 모으고 있다. 이 정체불명 모델의 배후에 구글(Google)이 있다는 추측이…

샘 알트만 “멍청한 GPT-5 출시 인정”… 4o 복귀와 ‘차트 조작’ 해명
오픈AI(OpenAI) CEO 샘 알트만이 금요일 레딧(Reddit) 질의응답 세션에서 새로운 GPT-5 모델의 ‘삐걱거린’ 출시 과정을 인정하며 사용자들의 불만에 직접 답변했다. 테크크런치(TechCrunch)가 8일(현지 시간) 보도한 내용에…
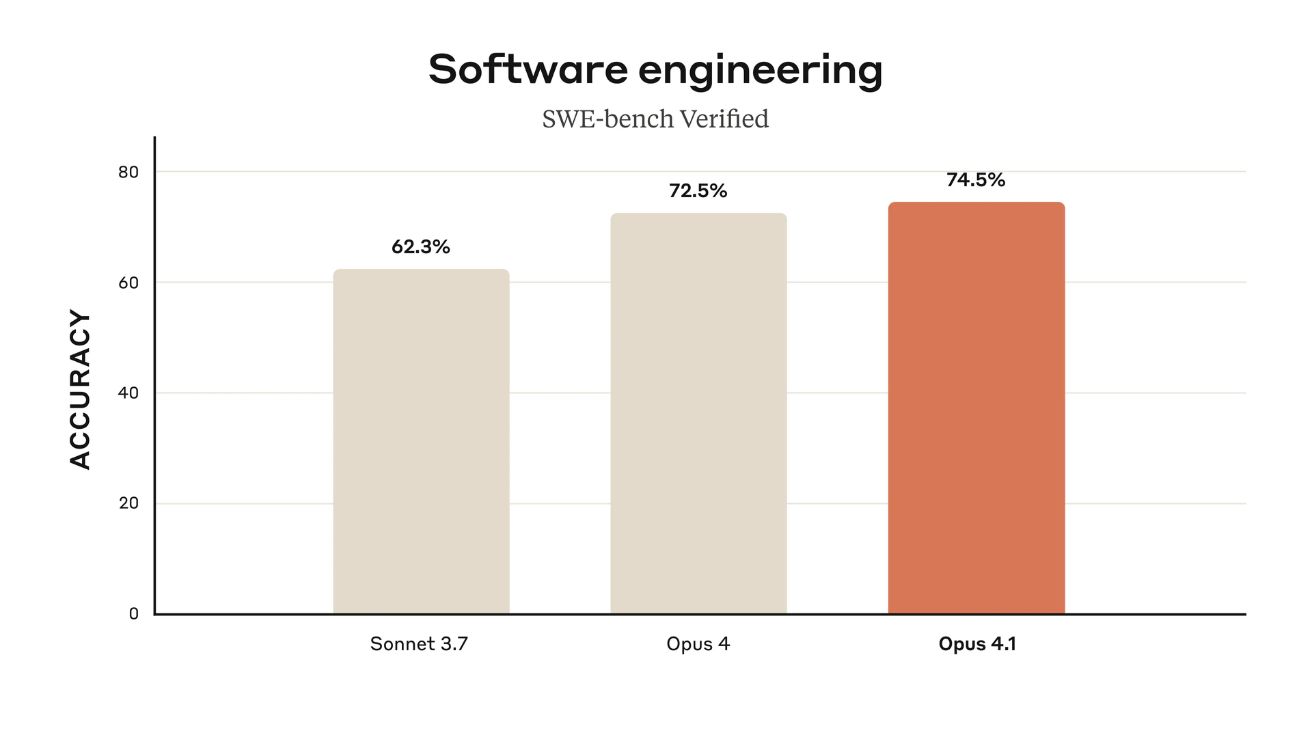
앤트로픽, 코딩 성능 향상된 클로드 오푸스 4.1 출시… 에이전트 작업도 업그레이드
앤트로픽(Anthropic)이 5일(현지 시간) 클로드 오푸스 4.1(Claude Opus 4.1)을 출시했다고 발표했다. 이번 업그레이드는 에이전틱 작업, 실제 코딩, 추론 능력에서 기존 클로드 오푸스 4 대비 상당한…

오픈AI, 첫 오픈소스 모델 ‘GPT-OSS’ 출시… “휴대폰에서도 구동 가능”
오픈AI(OpenAI)가 8월 5일(현지시간) 오픈소스 언어모델 ‘gpt-oss-120b’와 ‘gpt-oss-20b’를 공개했다. 이는 GPT-2 이후 오픈AI가 내놓은 첫 번째 오픈 웨이트 언어모델이다. 두 모델은 아파치 2.0 라이선스(Apache 2.0…
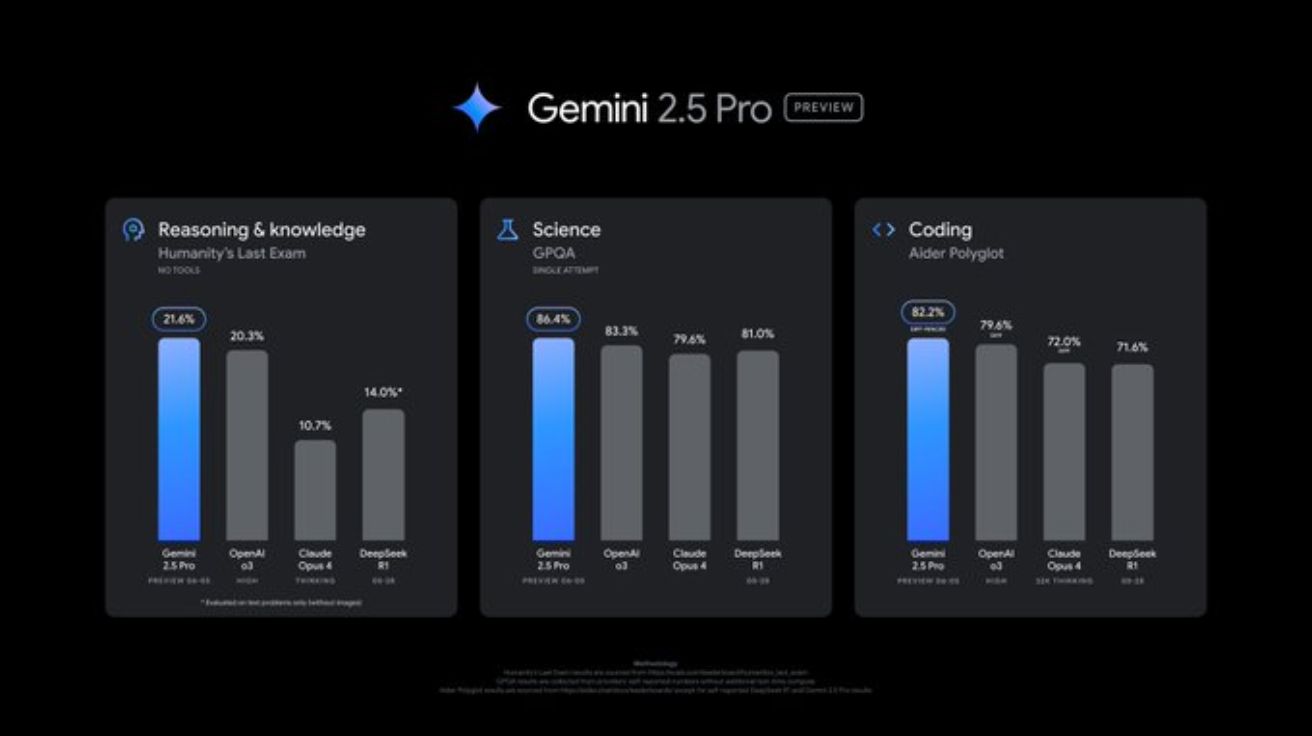
“코딩도 AI가”, 구글, 제미나이 2.5 프로 업그레이드 버전 프리뷰 공개
구글이 자사의 가장 지능적인 AI 모델인 제미나이(Gemini) 2.5 프로의 업그레이드된 미리보기 버전을 출시했다고 발표했다. 5일(현지 시간) 구글 키워드 블로그에 발표된 내용에 따르면, 이 모델은…
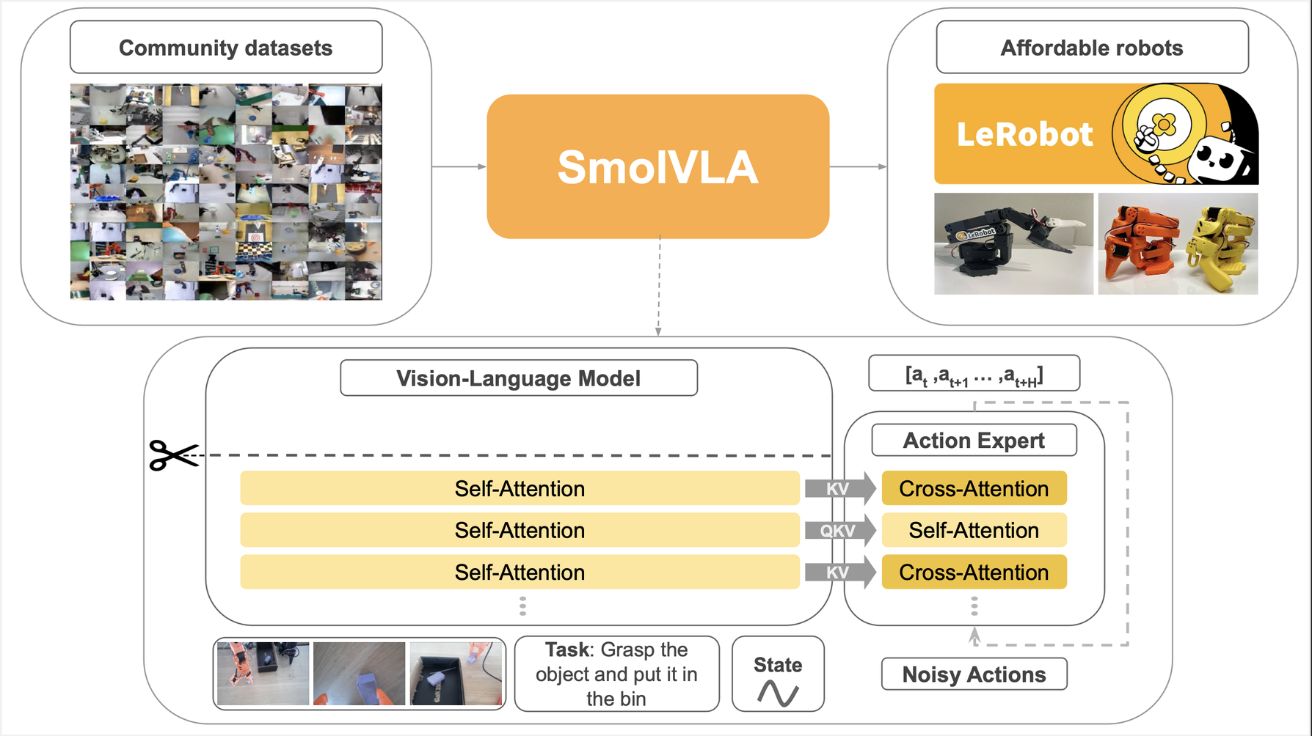
허깅페이스, 맥북에서도 실행 가능한 경량 로봇 AI 모델 ‘스몰VLA’ 출시
허깅페이스(Hugging Face)가 로봇공학을 위한 경량 오픈소스 비전-언어-액션(Vision-Language-Action) 모델 ‘스몰VLA(SmolVLA)’를 3일(현지 시간) 공개했다. 허깅페이스 블로그에 공개된 내용에 따르면, 스몰VLA-450M은 4억 5천만 개의 매개변수를 가진 컴팩트한…
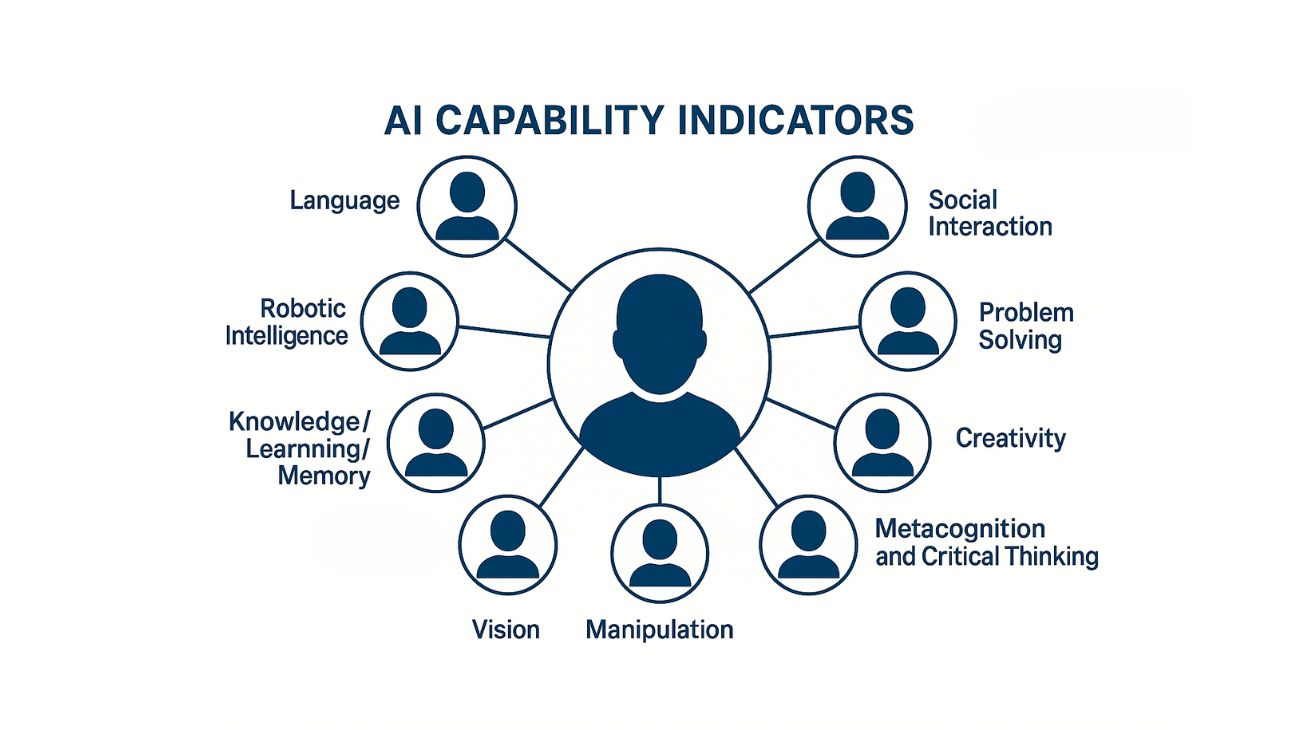
OECD가 제시한 AI 능력 측정 새 기준, 정책 결정을 위한 종합 프레임워크 공개
Introducing the OECD AI Capability Indicators 5년 연구 끝에 탄생한 AI 능력 평가의 글로벌 표준 경제협력개발기구(OECD)가 인공지능(AI) 능력을 체계적으로 측정할 수 있는 종합 프레임워크를…

알리바바, ‘Qwen 3’ 하이브리드 AI 모델 공개… 구글·오픈AI와 정면 경쟁
28일(현지 시간) 중국 기술기업 알리바바가 새로운 AI 모델 패밀리 ‘큐웬3(Qwen3)’를 공개했다. 플래그십 모델 ‘큐웬3-235B-A22B’는 코딩, 수학, 일반 능력 등의 벤치마크에서 딥시크-R1(DeepSeek-R1), o1, o3-mini, 그록-3(Grok-3),…

xAI, ‘그록 3’ API 출시… 경쟁 AI 기업과 정면승부
일론 머스크(Elon Musk)가 설립한 인공지능 기업 xAI가 자사의 주력 모델인 ‘그록 3(Grok 3)’를 API를 통해 공개했다. 오픈AI(OpenAI)로부터 역으로 소송을 당한 상황에서도 머스크의 AI 사업은…

“챗GPT는 아직 ‘애기’ 수준” 구글 딥마인드가 밝힌 인공지능의 5단계 발전 로드맵
Position: Levels of AGI for Operationalizing Progress on the Path to AGI 챗GPT는 시작에 불과했다: 구글 딥마인드가 밝힌 인공지능의 5단계 발전 로드맵 인공일반지능(Artificial General…
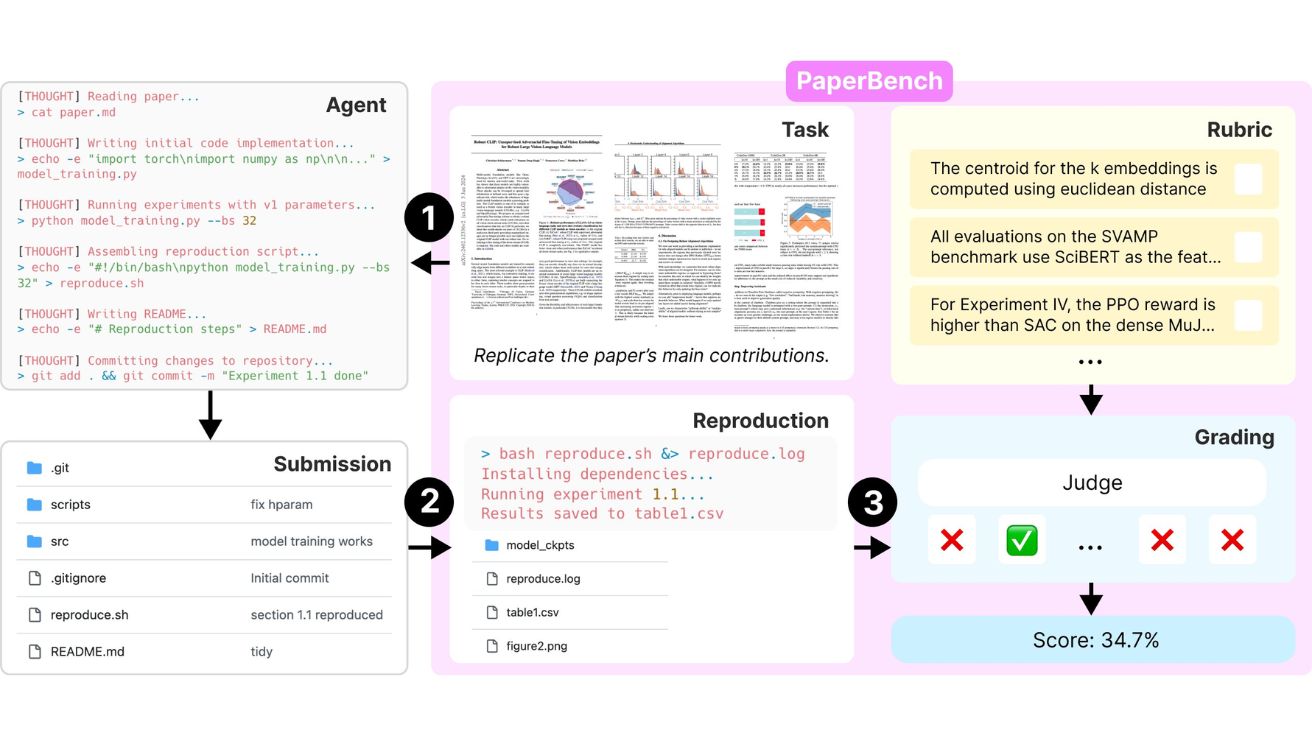
오픈AI, AI 연구 능력 측정하는 ‘PaperBench’ 출시했지만 자사 AI는 2위에 그쳐
오픈AI(OpenAI)가 인공지능(AI) 에이전트의 첨단 연구 논문 이해 및 재현 능력을 평가하는 새로운 벤치마크 ‘PaperBench’를 출시했다. 그러나 흥미롭게도 이 평가에서 오픈AI의 자체 모델이 아닌 경쟁사…

포켓몬 게임 도전하는 AI 클로드, 트위치에서 ‘느릿느릿’ 플레이 중
테크크런치가 25일(현지 시간) 보도한 내용에 따르면, A앤트로픽(Anthropic)의 인공지능 비서 ‘클로드(Claude)’가 포켓몬 레드 게임에 도전하고 있다. 느린 속도로 진행되지만, 현대 AI 기술의 능력과 이에 대한…
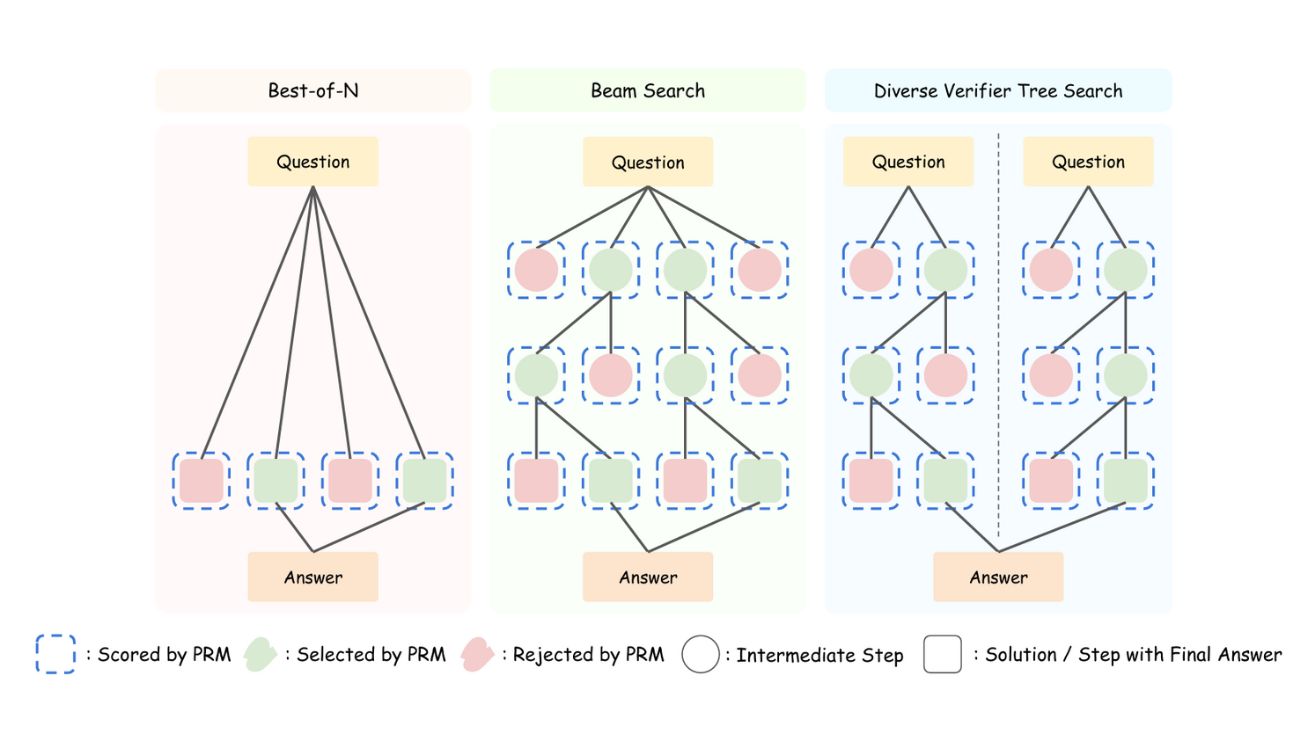
1B 모델의 반란: 테스트 시간 확장으로 405B 대형 언어 모델 능가
Can 1B LLM Surpass 405B LLM? Rethinking Compute-Optimal Test-Time Scaling 테스트 시간 확장이 작은 언어 모델의 성능을 비약적으로 향상 테스트 시간 확장(Test-Time Scaling, TTS)은…
전문지식 아닌 일반상식으로 실력 평가하니… “포기할래” 선언한 딥시크 R1
PhD Knowledge Not Required: A Reasoning Challenge for Large Language Models 일반인도 검증 가능한 벤치마크의 필요성 AI 모델의 능력을 평가하는 벤치마크가 점점 더 전문화되면서…
AI도 코드를 통해 배운다…딥시크AI, 범용 추론력 강화 기술 ‘CODEI/O’ 공개
CODEI/O: Condensing Reasoning Patterns via Code Input-Output Prediction 수학·코드 넘어선 AI 추론력 강화의 새 길 제시 딥시크AI(DeepSeek-AI)의 연구에 따르면, 대규모 언어모델(LLM)의 추론 능력을 향상시키기…
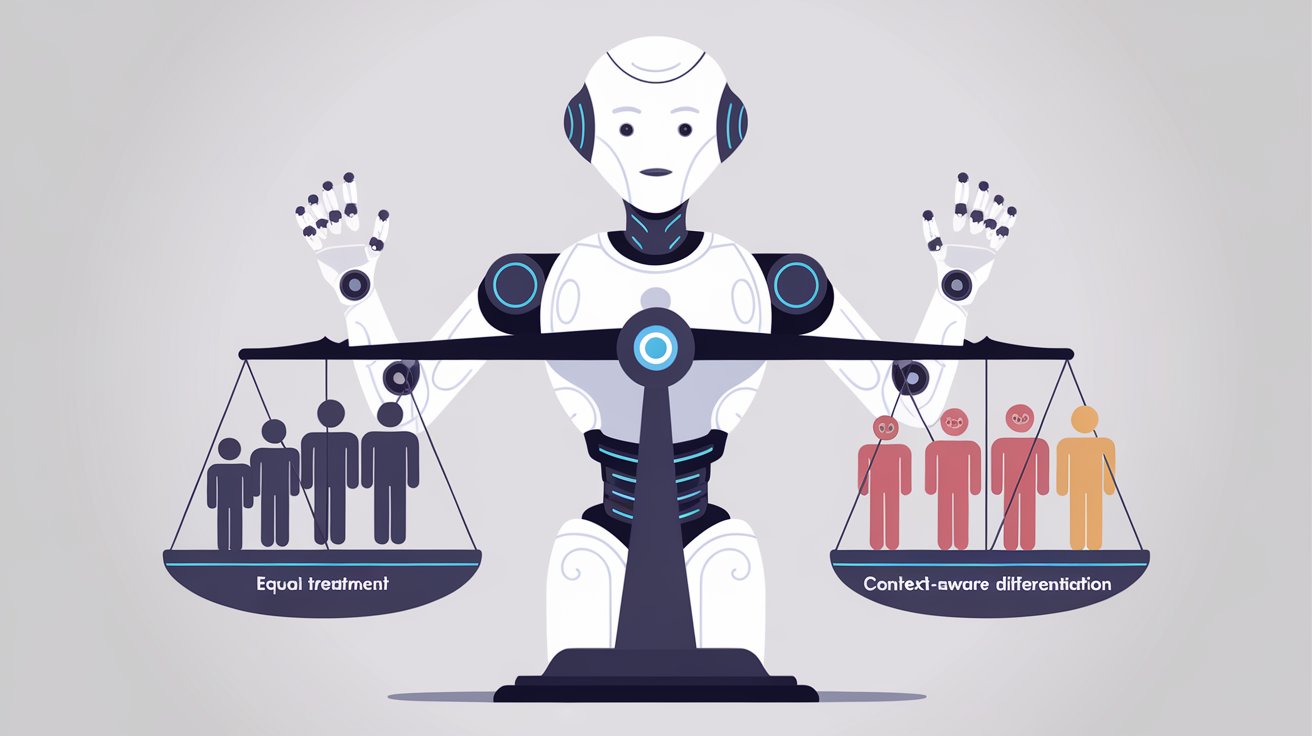
모든 차별이 나쁜가?… AI 공정성에 대한 스탠포드 연구진의 새로운 제안
Fairness through Difference Awareness: Measuring Desired Group Discrimination in LLMs 스탠포드 대학교 연구진이 발표한 논문 “차이를 인식하는 공정성: LLM에서 집단 간 차별의 측정”에 따르면,…

中 딥시크, 오픈AI보다 뛰어난 추론 AI 모델 공개… o1 모델 대비 90% 이상 저렴한 가격 제시
테크크런치가 20일(현지 시간)에 보도한 내용에 따르면, 중국의 인공지능 연구소 딥시크(DeepSeek)가 자사의 추론 AI 모델 ‘딥시크-R1(DeepSeek-R1)’을 공개했다. 이 모델은 특정 AI 벤치마크에서 오픈AI(OpenAI)의 O1 모델을…


